
Experten-Einstellungen für ChatGPT: Was bedeuten Temperature, Top-P und Co.?
Wusstest du, dass es Parameter gibt, mit denen man die OpenAI-Modelle hinter ChatGPT über die API und den Playground besser kontrollieren und präzisere Ausgaben erhalten kann? Die wichtigsten dieser Parameter erklären wir in diesem Artikel einfach und verständlich. Kein technisches Vorwissen nötig!
Wie funktionieren Sprachmodelle à la ChatGPT?
Sprachmodelle erzeugen Texte, indem sie vorhersagen, wie wahrscheinlich das nächste Wort bzw. die nächste Silbe ist. In der Fachsprache sind diese Textbausteine als „Tokens“ bekannt. Das Sprachmodell analysiert den bisherigen Text und wählt die Fortsetzung auf Basis von Wahrscheinlichkeiten aus.
Der gesamte Eingabetext wird dabei Silbe für Silbe erweitert. Wenn ein Erweiterungsschritt abgeschlossen ist, wird der gesamte bis hierhin erzeugte Text dann wieder in das Sprachmodell eingegeben. Das passiert so lange, bis das Sprachmodell selbst ein Stoppsignal sendet und den Text als abgeschlossen markiert. In der folgenden Abbildung erkennt man, wie der gesamte Text “SPRACHMODELLE ERZEUGEN TEXTE,” als Grundlage für die Berechnung der Wahrscheinlichkeit des nächsten Textbausteins dient.
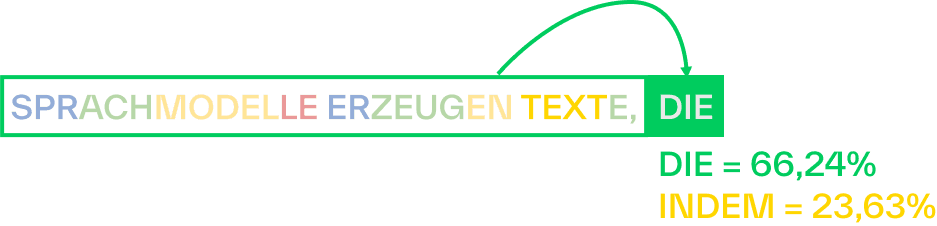
Wahrscheinlichkeiten für den nächsten Textbaustein
Die Fortsetzung mit “DIE” wurde vom Sprachmodell als wahrscheinlicher eingestuft als die Fortsetzung des Textes mit “INDEM”. Diese Einstufung basiert auf den Trainingsdaten, mit denen das Modell ursprünglich trainiert wurde, und ist maßgeblich für die Ausgaben. Diese Trainingsdaten bestehen aus riesigen Mengen an Texten, in denen das Sprachmodell sich wiederholende Muster erkennt. Auf Basis dieser Daten werden dann die Vorhersagen getroffen und wir erhalten die Fortsetzung mit “DIE VON MENSCHEN GESCHRIEBEN ZU SEIN SCHEINEN”.

Vollständige Ausgabe Das Sprachmodell entscheidet sich jedoch nicht immer für die wahrscheinlichste Lösung. Das verhindert, dass bereits existierende Texte aus den Trainingsdaten 1:1 wiedergegeben werden, und sorgt für vielfältigere Ausgaben. Hier kommt der Einfluss der nachfolgenden Parameter ins Spiel, über die wir die Vielfalt und Kreativität der Ausgaben steuern können.
Parameter von Sprachmodellen
Temperature – Was bedeutet Temperature bei OpenAI-Modellen?
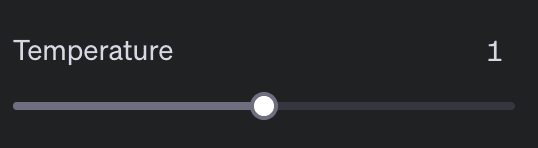
Temperature-Parameter
Die "Temperature" ist ein Parameter, der kontrolliert, wie kreativ oder fokussiert die generierten Texte sind. Sie beeinflusst, welcher Textbaustein als Nächstes gewählt wird, denn sie verändert die Verteilung der Wahrscheinlichkeiten einzelner Tokens.
Höhere Werte (zum Beispiel 1,5) sorgen dafür, dass unwahrscheinlichere Tokens im Vergleich zu wahrscheinlicheren Tokens häufiger ausgewählt werden, und machen die Ausgaben damit zufälliger. Allerdings kann eine zu hohe Temperature auch zu unsinnigen Ausgaben führen, bei denen das Modell komplett zufällige Tokens auswählt und die Ausgaben keinen Sinn mehr ergeben.
Niedrigere Werte (zum Beispiel 0,2) machen die Verteilung steiler und die Ausgaben somit fokussierter und deterministischer.
Höhere Temperature-Werte helfen bei kreativen Schreibprojekten oder Brainstorming-Sessions, da so unerwartete und originelle Ideen erzeugt werden können. Niedrigere Werte hingegen sind besser geeignet für Anwendungen, bei denen Präzision und Konsistenz wichtig sind, wie etwa bei professionellen E-Mails oder technischen Dokumentationen.
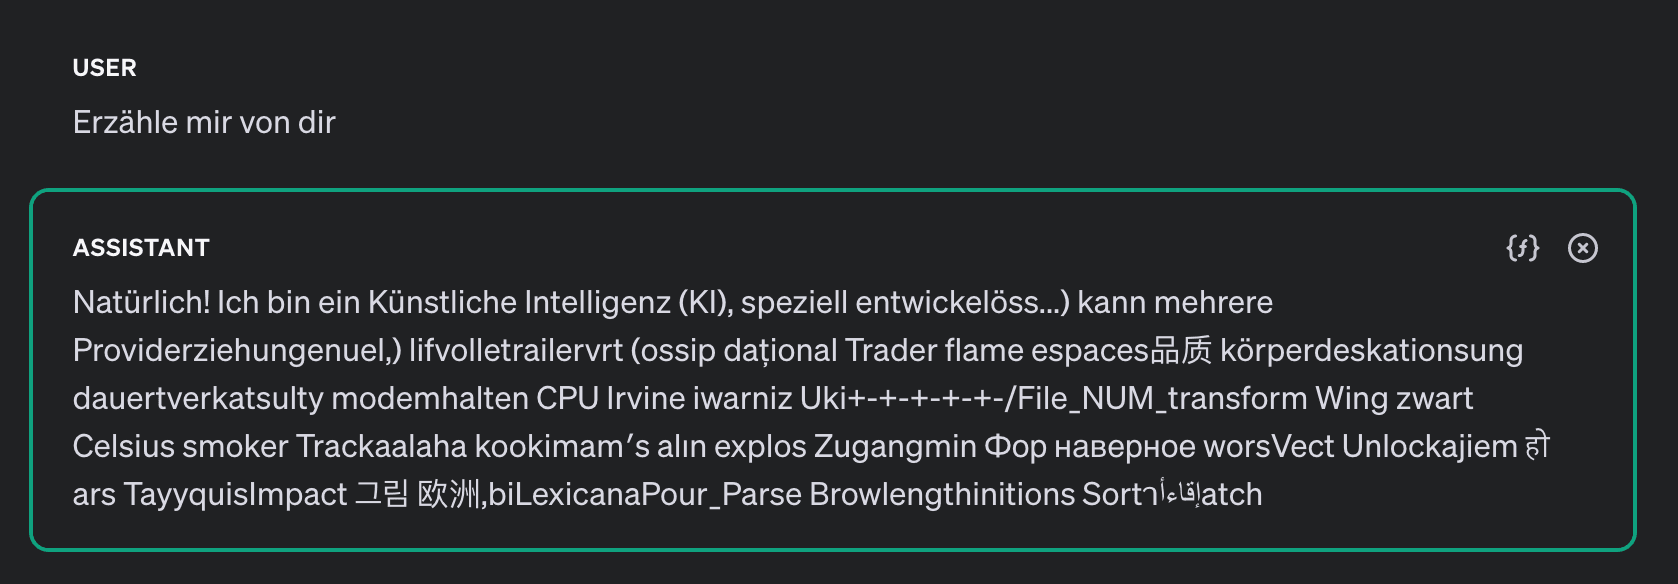
Unsinnige Ausgabe bei hohem Temperature-Wert von 1,8
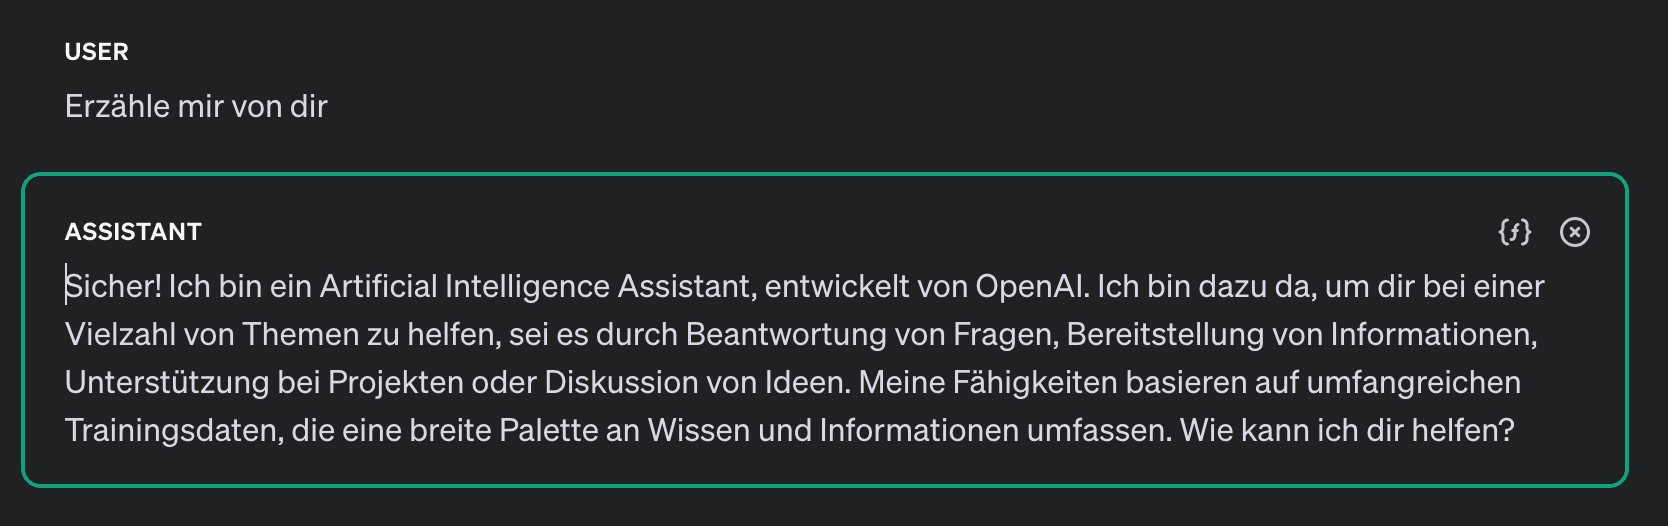
Ausgabe bei Temperature von 1,0
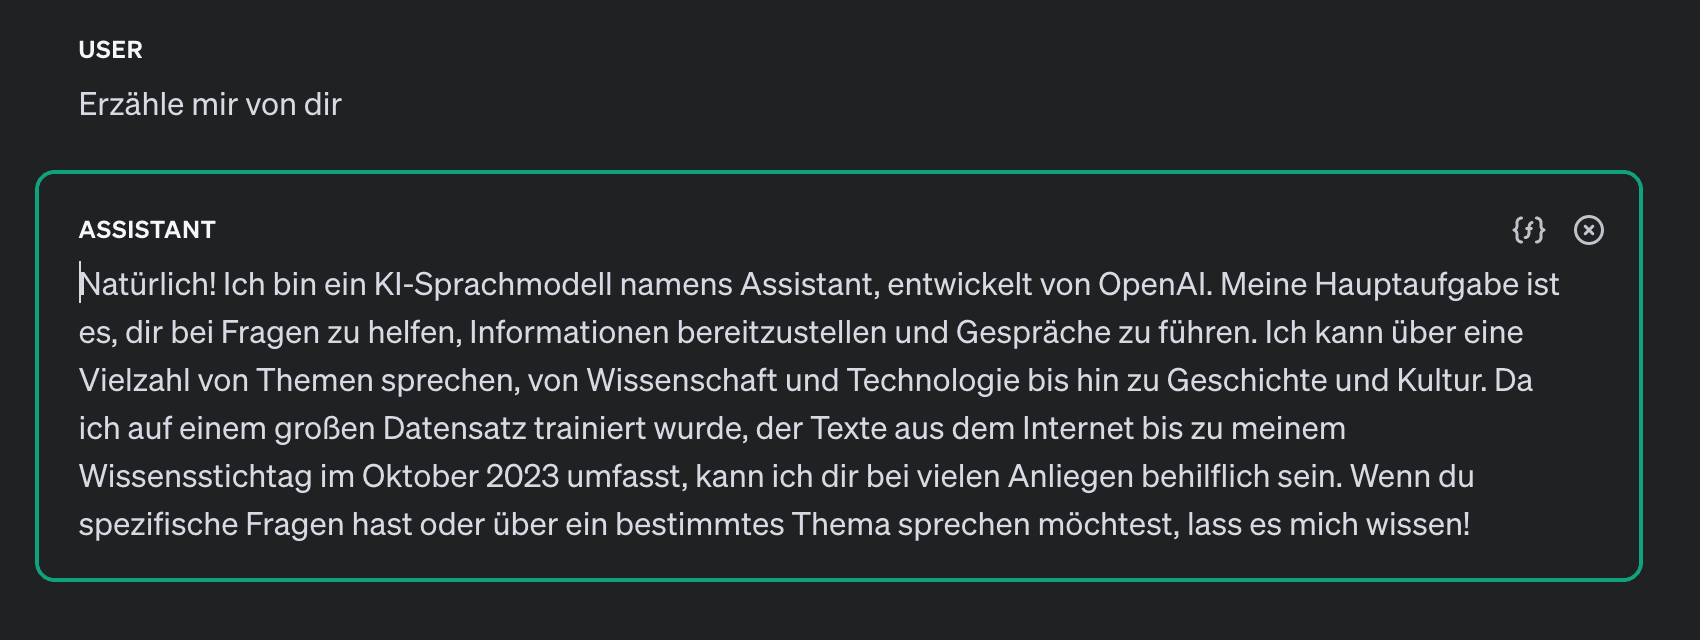
Ausgabe bei Temperature von 0,2
Top-P – Was bedeutet Top-P bei OpenAI-Modellen?
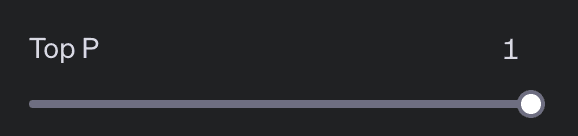
Top-P-Parameter
Der Top-P-Parameter steuert, welche Tokens in die engere Auswahl einbezogen werden. Betrachtet werden nur die Tokens mit der höchsten Wahrscheinlichkeit, bis deren kumulative Wahrscheinlichkeit den Top-P-Wert überschreitet. Der maximale Wert für diesen Parameter ist 1, da die Summe aller Wahrscheinlichkeiten immer höchstens 100 % beträgt. Ein Top-P von 0,8 bedeutet, dass nur die Tokens berücksichtigt werden, die zusammen 80 % der höchsten Wahrscheinlichkeit ergeben. Im Beispiel der Abbildung wären das “DIE” und “INDEM”. Andere Tokens werden dann nicht mehr bei der Auswahl berücksichtigt.
Das ist insbesondere dann relevant, wenn du mit einer hohen Temperatur arbeitest, um kreativere Ergebnisse zu erzielen. So kannst du über den Top-P-Parameter die unbrauchbaren Resultate herausfiltern, ohne die Kreativität zu reduzieren.
In Kombination mit einer hohen Temperature sollte dieser Parameter daher abgesenkt werden, um weiterhin sinnvolle Ausgaben zu erzeugen.
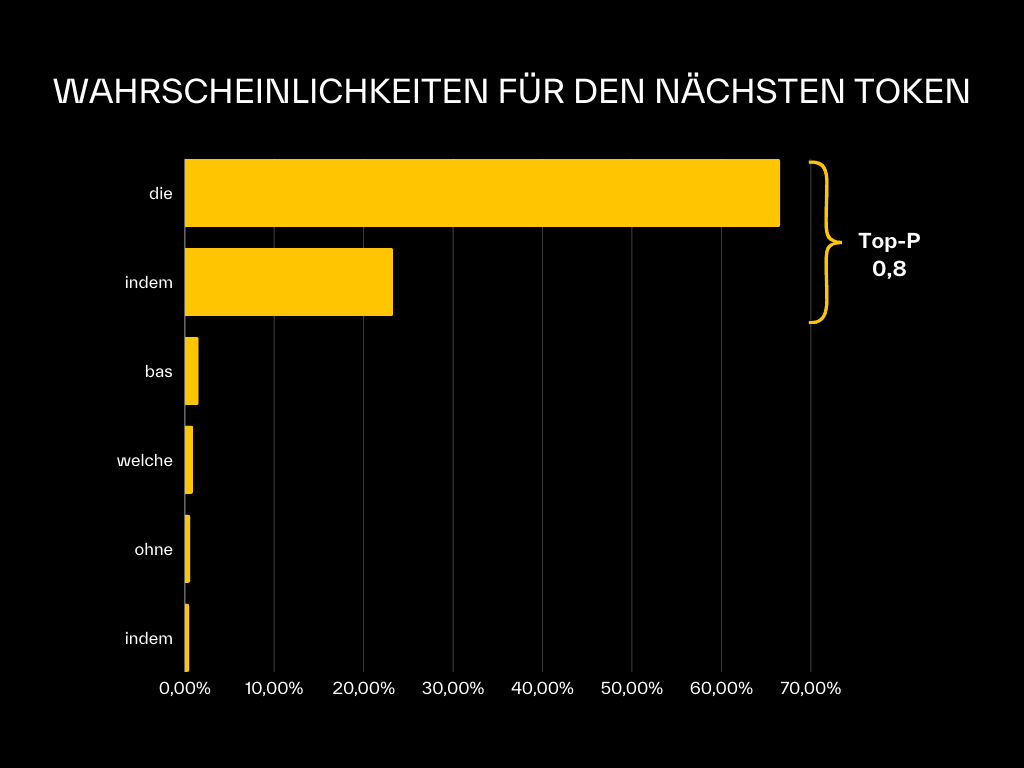
Wahrscheinlichkeitsverteilung für den nächsten Textbaustein mit Top-P 0,8
Was bedeuten Frequency Penalty und Presence Penalty bei ChatGPT?
Frequency-Penalty-Parameter
Presence-Penalty-Parameter
Durch die Parameter Presence Penalty und Frequency Penalty wird die Generierung von vielfältigeren und kreativeren Texten gefördert, indem das Modell dazu angeregt wird, neue Themen und Wörter einzuführen.
Dabei reguliert der Frequency Penalty die Wahrscheinlichkeit, dass das Modell häufig vorkommende Wörter wiederholt. Ein höherer Wert verringert die Wahrscheinlichkeit von Wiederholungen, indem er die Verwendung häufig bereits im Text vorkommender Wörter oder Phrasen einschränkt. Je häufiger der Textbaustein dabei bereits vorkommt, desto unwahrscheinlicher wird ein weiteres Vorkommen in der Ausgabe. Im Gegensatz dazu bewirkt der Presence-Penalty-Parameter, dass die Wahrscheinlichkeit, Wörter oder Phrasen, die bereits im generierten Text vorkommen, erneut zu verwenden, reduziert wird. Der Unterschied zum Frequency Penalty ist, dass hier bereits das einmalige Vorkommen des Textbausteins in der Berechnung der Wahrscheinlichkeit bestraft wird, wohingegen beim Frequency Penalty die Häufigkeit bestraft wird. Beide Parameter können in der OpenAI-API Werte zwischen −2 und 2 annehmen (Standardwert: 0).
Verwendung
Ein höherer Wert fördert die Verwendung selten genutzter oder neuer Wörter, was zu einem vielfältigeren und kreativeren Text führt. Dahingegen resultiert ein niedrigerer Wert in einer häufigeren Verwendung gängiger Wörter, was den Text leichter verständlich machen kann.
Typischerweise werden Werte um 0,1 genutzt, um die Anzahl von Wiederholungen leicht zu reduzieren. Hohe Werte sorgen dafür, dass sich das Modell gar nicht mehr wiederholt. Das kann die Qualität des Textes stark beeinträchtigen.
Max Tokens - Wie stelle ich die Länge der Antworten über die API ein?
“Max Tokens” legt fest, wie viele Tokens das Modell maximal in einer Antwort generieren darf. Ein Token kann ein Wort oder ein Teil eines Wortes sein und entspricht grob einer Silbe. Dieser Parameter dient dazu, die Länge des generierten Textes zu kontrollieren. In der Chat-Completions-Schnittstelle der OpenAI-API heißt er inzwischen max_completion_tokens und zählt auch die Reasoning-Tokens mit.
Verwendung
Wenn “Max Tokens” zu niedrig eingestellt ist, kann dies zu abgeschnittenen und unverständlichen Antworten führen. Ist es zu hoch eingestellt, können unnötig lange und ausschweifende Antworten entstehen. Über diesen Parameter lassen sich auch Kosten reduzieren, da bei Nutzung der OpenAI-API nach generierten Tokens abgerechnet wird. Durch die richtige Einstellung von “Max Tokens” können Entwicklungsteams und Nutzende die Länge und Qualität der generierten Antworten optimieren und gleichzeitig die Kosten kontrollieren.
Optimale Einstellung der Parameter
Optimale Einstellung der ChatGPT-Parameter für kreative Texte
Bei der Erstellung von kreativen Texten, z. B. zu Brainstorming-Zwecken, sollten die Temperatur & Frequency Penalty erhöht und Top-P abgesenkt werden. Der Maximum-Tokens-Parameter sollte nach Bedarf nachjustiert werden, um unnötige Kosten zu vermeiden.
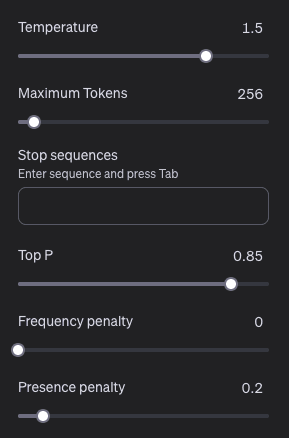
Optimale Einstellung für Kreativität
Optimale Einstellungen der ChatGPT-Parameter für neutrale Inhalte
Hier bietet es sich an, die Parameter eher auf den Standardeinstellungen zu belassen und lediglich den Temperaturwert nach unten zu korrigieren.
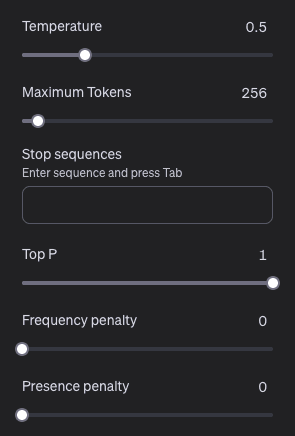
Optimale Einstellung für Sachlichkeit
Fazit
Es ist grundsätzlich sinnvoll, die oben beschriebenen Parameter im Zuge der Aufgabe selbst zu justieren, bis man mit den Ausgaben vollkommen zufrieden ist.
Um den Einfluss der einzelnen Parameter auf die Ausgaben zu verdeutlichen, verwenden wir den OpenAI Playground. In der Nutzeroberfläche von ChatGPT existiert leider keine Option, diese Parameter zu verändern: Unter den Personalisierungseinstellungen kannst du nur Stil und Tonfall, einzelne Eigenschaften und eigene Anweisungen festlegen (Stand: November 2026). Jedoch können die Parameter bei der Nutzung der OpenAI-API z. B. für eigene Anwendungen genutzt werden. Bei den aktuellen GPT-6-Modellen fallen Temperature und Top-P allerdings weg, sobald das Modell mit Reasoning arbeitet; GPT-6 Astra und GPT-6.1 Sol unterstützen sie deshalb gar nicht mehr. Solltest du beim Entwickeln deiner eigenen KI-Anwendung Hilfe benötigen, melde dich bei uns. Wir helfen gerne!
Wenn du noch tiefer in ChatGPT einsteigen willst, dann empfehlen wir dir, den besten ChatGPT-Kurs, der online verfügbar ist, zu machen.
100 % kostenloser ChatGPT-Prompting-Kurs
Verwandte Artikel
- Technologie
KI-Agenten in der Unternehmenspraxis: Von gescheiterten Automatisierungsversuchen zu hybriden Arbeitsmodellen
Warum die Zukunft nicht in der Vollautomatisierung liegt, sondern im Zusammenspiel von Mensch und KI.11. Juli 2025 - Technologie
KI-Agenten sicher einsetzen: Das SAFE-Framework für höchste Sicherheitsstandards in KMU
Vier Säulen, mit denen du KI-Agenten im Unternehmen sicher einsetzt.6. Juli 2025 - News
beansandbytes beteiligt sich an PyleHound
Wir beteiligen uns strategisch an PyleHound, dem Anbieter für KI-gestützte Dokumentenprüfung.24. Oktober 2025